生物信息分析

生物信息分析是米源生物的核心业务。我们以解决问题为导向,覆盖基因组组装、群体遗传、基因定位、全基因组选择与多组学联合分析,尤其擅长复杂基因组与个性化分析。

01

基因组组装与注释

de novo 组装 / T2T

基于三代长读长从头组装,逐步提升至染色体级与 gap-free 的端粒到端粒(T2T)水平,覆盖高重复与复杂区域。

泛基因组 / 超级泛基因组

对多个样本进行从头组装,构建泛基因组或跨物种的超级泛基因组,解析核心、可变与非必需基因集。

基因组注释

整合转录组、同源比对与蛋白证据,进行基因结构预测与功能注释,输出可直接用于分析的注释集。

比较基因组

开展种间 / 种内比较,分析共线性、基因家族扩张收缩与演化,揭示基因组结构与功能差异。
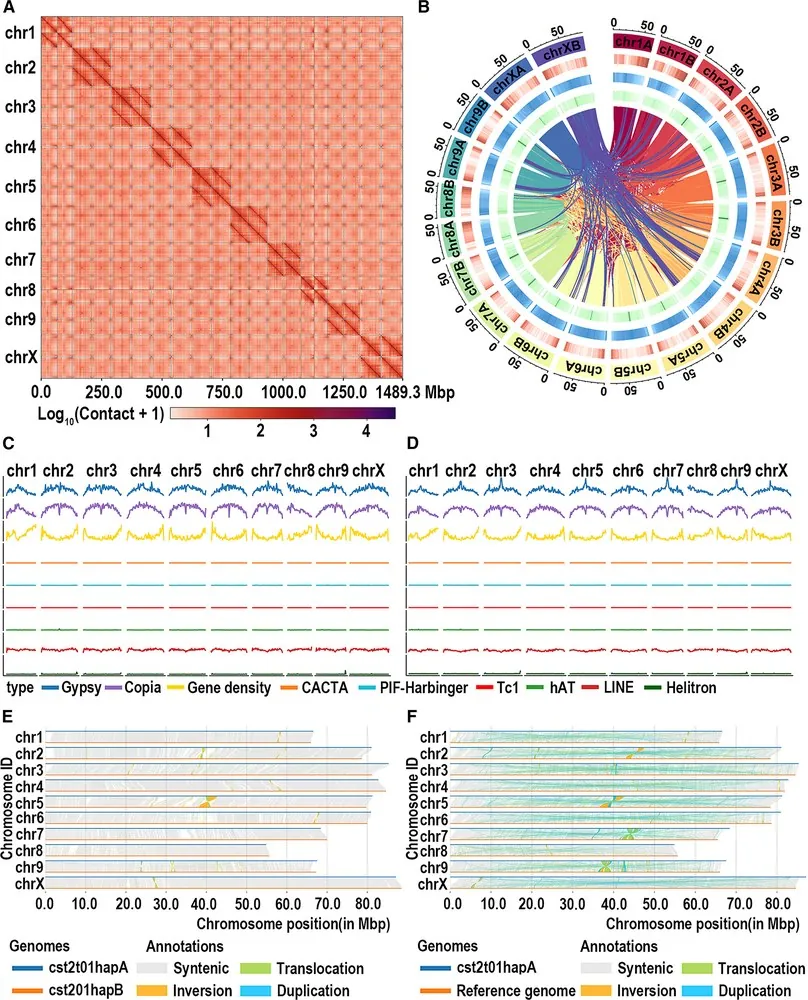
大麻 T2T 基因组组装与共线性结构
大麻单倍型 T2T 基因组组装与共线性结构 引用来源:Plant Commun. 2026, 7, 101913. doi:10.1016/j.xplc.2026.101913

组装是基因组学研究的地基。我们依托 PacBio HiFi、ONT 超长读长与 Hi-C 等技术,完成从 de novo 到染色体级直至 T2T(端粒到端粒)的高质量组装,并构建泛基因组 / 超级泛基因组、开展结构与功能注释,为下游群体、定位与育种分析提供可靠参考。

服务内容包括:组装策略评估、HiFi/ONT/Hi-C 数据联合组装、染色体挂载与 T2T 补洞、重复序列与着丝粒解析,以及基于多证据的基因结构与功能注释。交付标准化的组装序列、注释文件与统计报告,可直接用于后续群体与育种分析。

应用:参考基因组构建、结构变异挖掘、基因家族与演化研究、分子标记开发。
02

群体遗传与进化

极速变异检测

针对大队列样本高效完成 SNP/InDel/PAV 等变异检测,兼顾速度与准确性,支撑大样本量群体研究。

群体结构 / 多样性

通过 PCA、群体结构、遗传距离与核苷酸多样性等分析,刻画群体的遗传分化与亲缘关系。

进化与选择清除

分析驯化、进化与选择清除信号,定位受选择区域,挖掘与驯化和改良相关的关键位点。

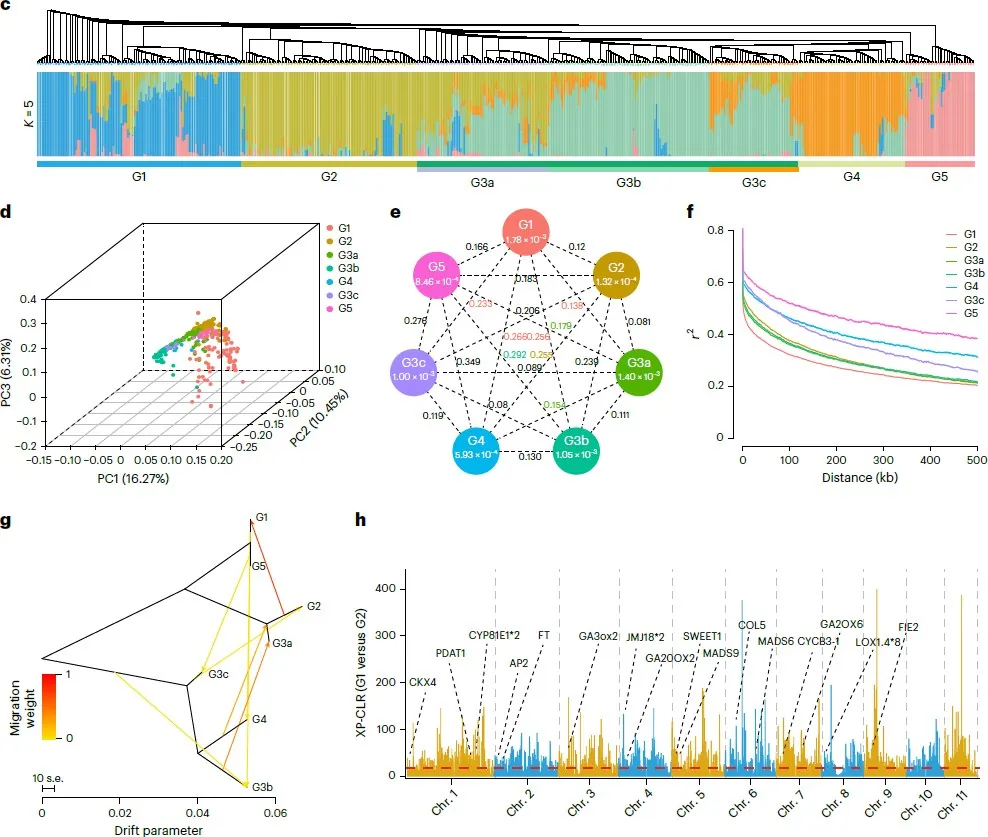
绿豆泛基因组与群体结构分析
绿豆图形泛基因组与群体遗传进化分析 引用来源:Nat. Genet. 2026. doi:10.1038/s41588-026-02644-5

面向大规模重测序群体,我们提供从变异检测到群体结构、遗传多样性、进化与选择清除的全流程分析,帮助厘清种群的遗传关系、驯化历史与优异等位变异。

分析内容涵盖变异过滤与质控、系统发育与群体结构、连锁不平衡与遗传多样性、主成分与聚类、群体分化(Fst)以及 XP-CLR、iHS 等选择清除检测。可结合表型与地理信息开展环境关联,为种质评价与驯化研究提供数据支撑。

应用:群体结构、驯化与进化研究、种质资源评价与选择信号分析。
03

性状基因定位

全基因组关联分析(GWAS)

在自然群体中开展性状关联分析,挖掘与目标性状显著关联的位点与候选基因。

遗传图谱构建与 QTL 定位

基于连锁分析构建高密度遗传图谱,定位 QTL 区间并解析性状的遗传基础。

BSA 及其变体

利用 BSA/BSR-seq 等混池定位方法,快速缩小目标区间,加速基因克隆进程。

定制化基因定位方案

针对特殊群体、复杂性状或非常规材料,定制化设计定位策略与分析流程。

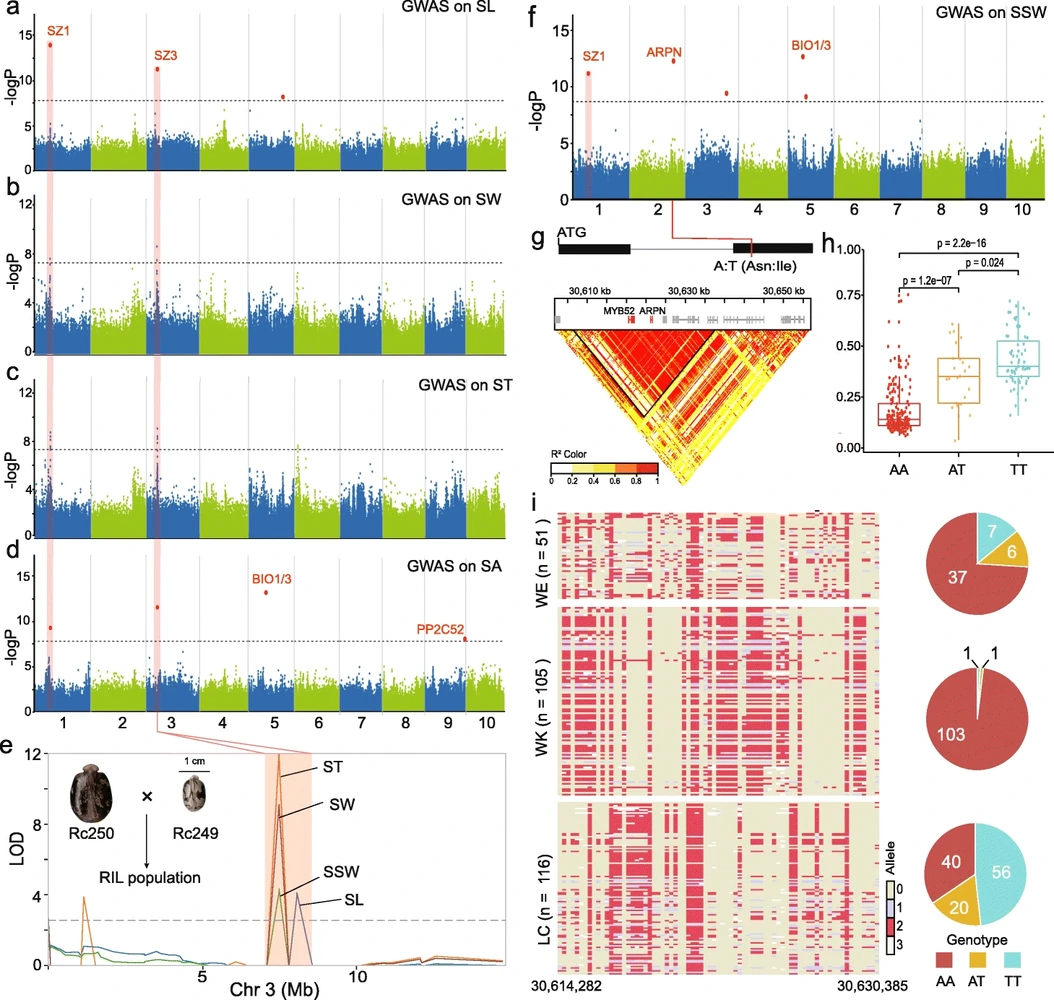
蓖麻全基因组关联分析(GWAS)与驯化选择
蓖麻全基因组重测序与农艺性状 GWAS 分析 引用来源:Genome Biol. 2021, 22, 111. doi:10.1186/s13059-021-02333-y

围绕重要农艺性状,我们整合 GWAS、遗传图谱与 QTL 定位、BSA 及其变体等多种策略,并针对特殊群体或性状定制方案,高效锁定候选基因与分子标记。

从群体设计、标记密度与统计模型选择,到关联信号检验、候选区间注释与候选基因功能解读,我们覆盖完整流程。可综合 GWAS、QTL 与 BSA 结果进行多策略交叉验证,提高定位的稳健性与可信度。

应用:重要农艺性状基因挖掘、候选基因筛选与分子标记开发。
04

全基因组选择分析(科研)

GS 模型构建

采用多种算法构建预测模型,并结合交叉验证筛选最优模型与参数组合。

预测评估

评估模型的预测精度与泛化能力,比较不同方法与场景下的表现。

方法学探索

研究机器学习 / 深度学习等预测方法,探索复杂性状预测的新思路与新模型。

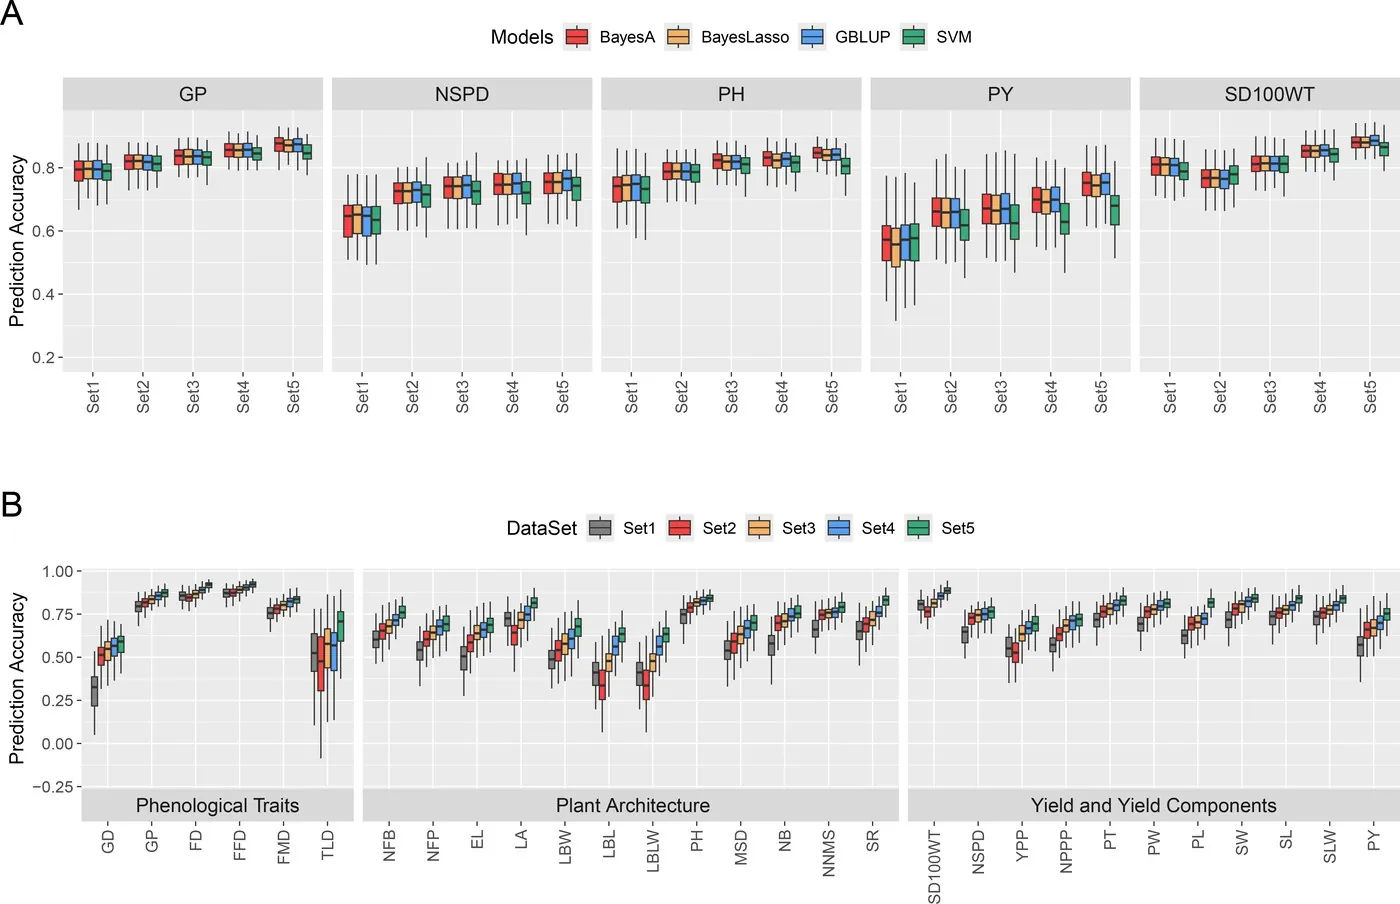
小豆全基因组选择预测精度与模型评估
小豆重要农艺性状全基因组选择(GS)预测精度评估 引用来源:Hortic. Res. 2026, uhag346. doi:10.1093/hr/uhag346

面向学术科研,我们帮助构建与优化全基因组选择模型,聚焦预测方法学与模型评估,支撑方法探索与科研论文产出。

分析涵盖表型与基因型数据清洗、群体划分与交叉验证设计、多算法(GBLUP、贝叶斯、机器学习等)建模、预测精度与稳健性评估,以及方法比较与可复现流程。适合开展预测方法学研究与论文方法部分支撑。

应用:复杂性状预测方法研究、预测模型评估与科研论文产出。
05

多组学联合分析

转录 + 代谢

关联基因表达与代谢物丰度,定位关键代谢通路,锁定调控节点。

转录 + 蛋白

联合转录组与蛋白质组,解析转录后与翻译层面的调控机制。

表观 + 转录

结合表观修饰与转录数据,从表观层面解释基因表达差异的成因。

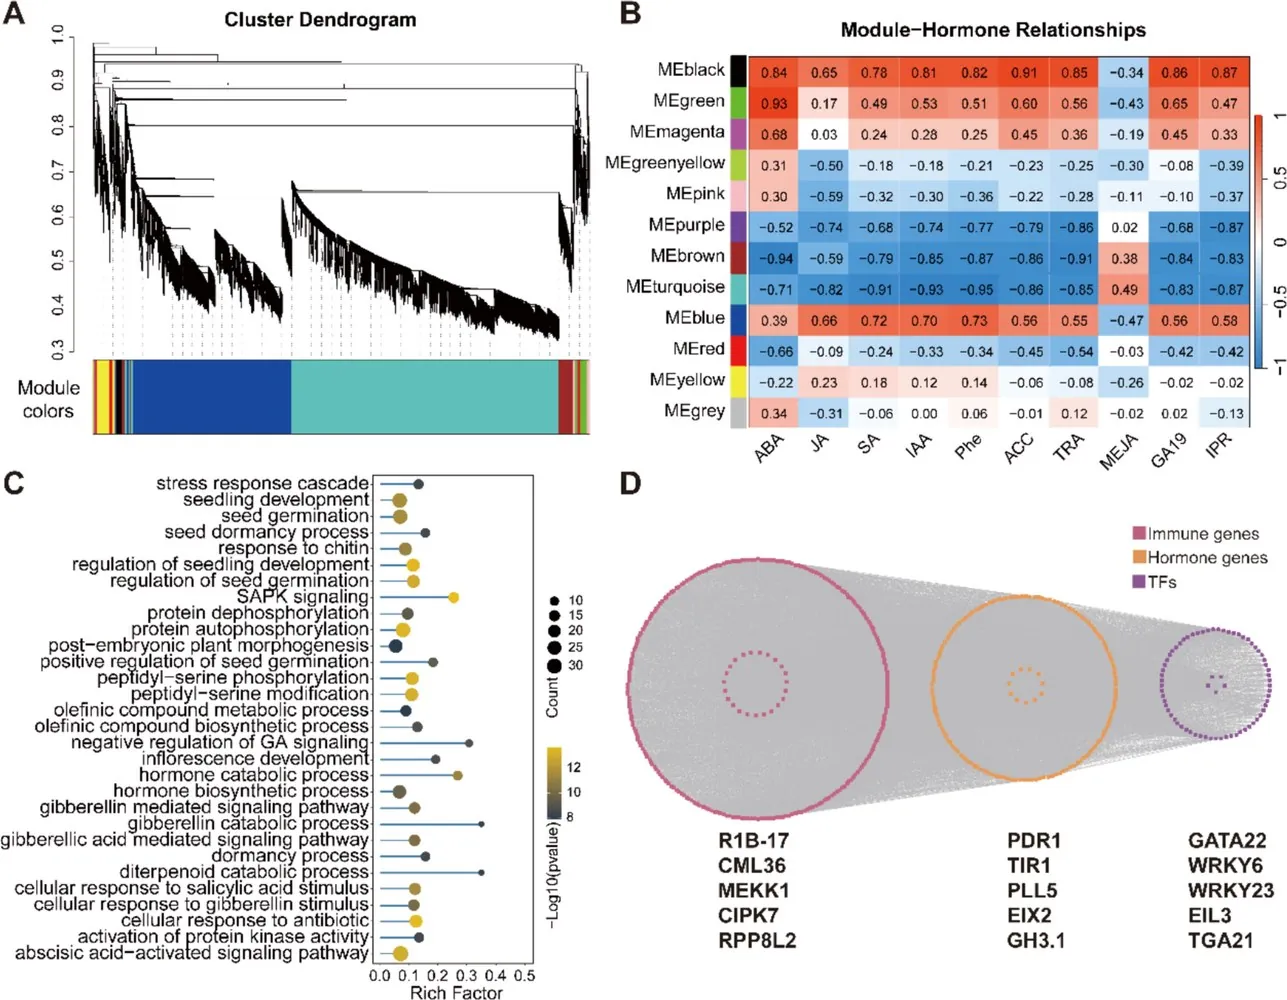
烟草时间序列转录组与代谢组联合分析
烟草响应野火病菌侵染的时间序列多组学调控网络 引用来源:J. Adv. Res. 2026, 88, 117–133. doi:10.1016/j.jare.2026.01.036

我们将基因组、转录组、蛋白质组、代谢组与表观组等多层数据联合解析,构建基因型—表型调控网络,揭示复杂性状的分子机制。

从多组学数据预处理与质控,到关联网络构建、差异与共表达分析、通路富集与调控推断,我们打通组学间的数据链路。可选单细胞、空间转录组等前沿数据整合,输出可用于论文的调控网络与机制解读。

应用:调控网络解析、品质与抗逆机制研究、候选基因挖掘。
06

数据库与平台搭建

多组学数据库

集成基因组浏览、BLAST 检索与位点查询等功能,集成基因组浏览、BLAST 检索与位点查询。

分析流程搭建

搭建标准化、可复用的分析流程,保证结果一致并减少重复劳动。

部署方式

支持本地或云端部署,兼顾数据安全、访问权限与团队协作需求。

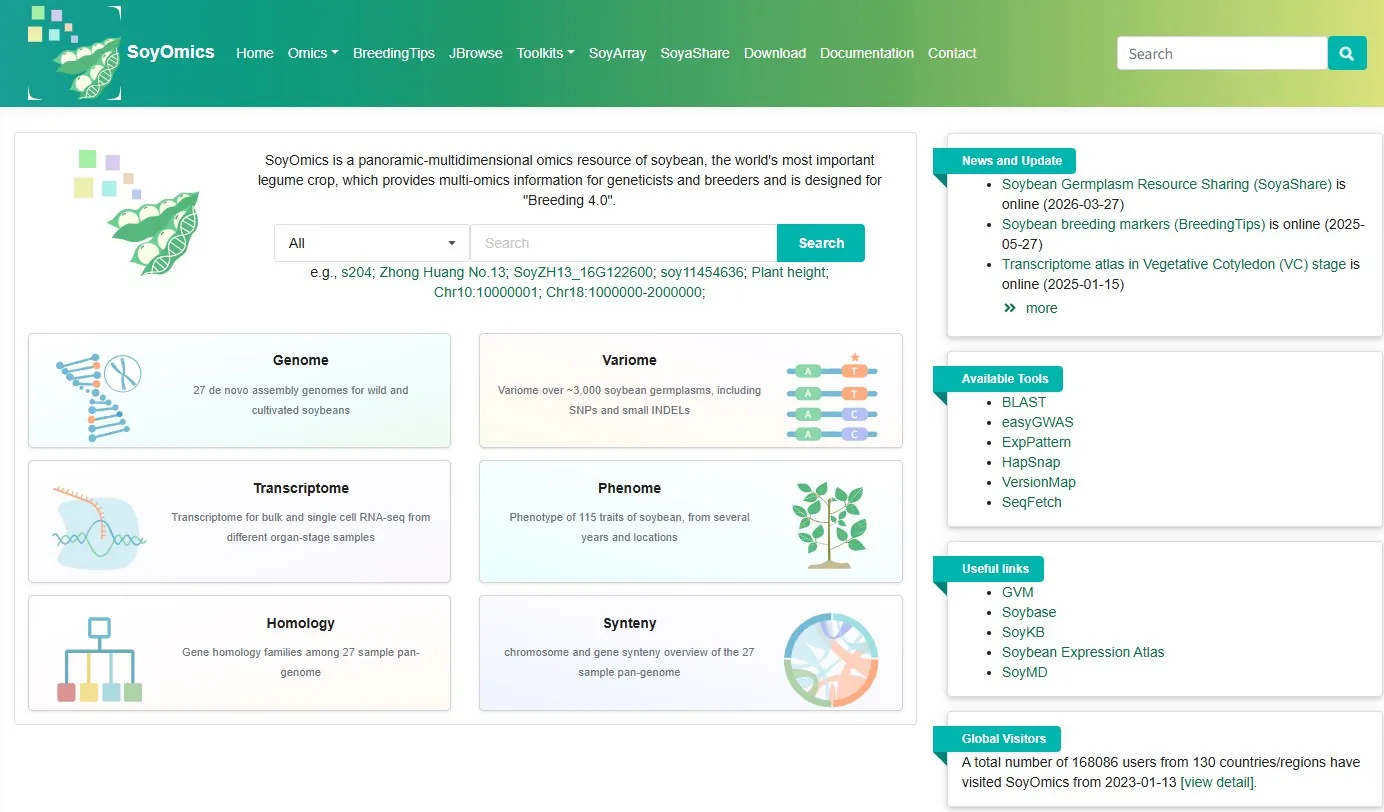
SoyOmics 大豆全景多维组学大数据平台
SoyOmics 大豆多维组学数据与在线生信分析平台 引用来源:Plant Commun. 2024 / Mol. Plant 平台应用示范

我们为科研单位搭建基因组浏览器、BLAST、GWAS 位点查询等多组学数据库与分析平台,实现数据资产化保存、团队共享与在线复用。

平台集成数据导入与管理、基因组浏览、BLAST 与位点检索、可视化查询与权限管理等功能,并支持流程编排与结果复现。我们提供从需求梳理、库表设计到部署上线与培训的完整实施,确保平台可持续使用。

应用:科研数据资产化保存、团队数据管理与共享查询。
07

科研定制与高级绘图

个性化分析

围绕具体科学问题定制分析方案与统计建模,而非套用标准流程。

高级可视化

绘制 Circos 圈图、共线性图、网络互作图、单细胞与多组学联合图、三维基因组图谱等出版级图表。

论文合作

提供从数据分析到论文成稿的分析与写作支持,可开展深度合作。

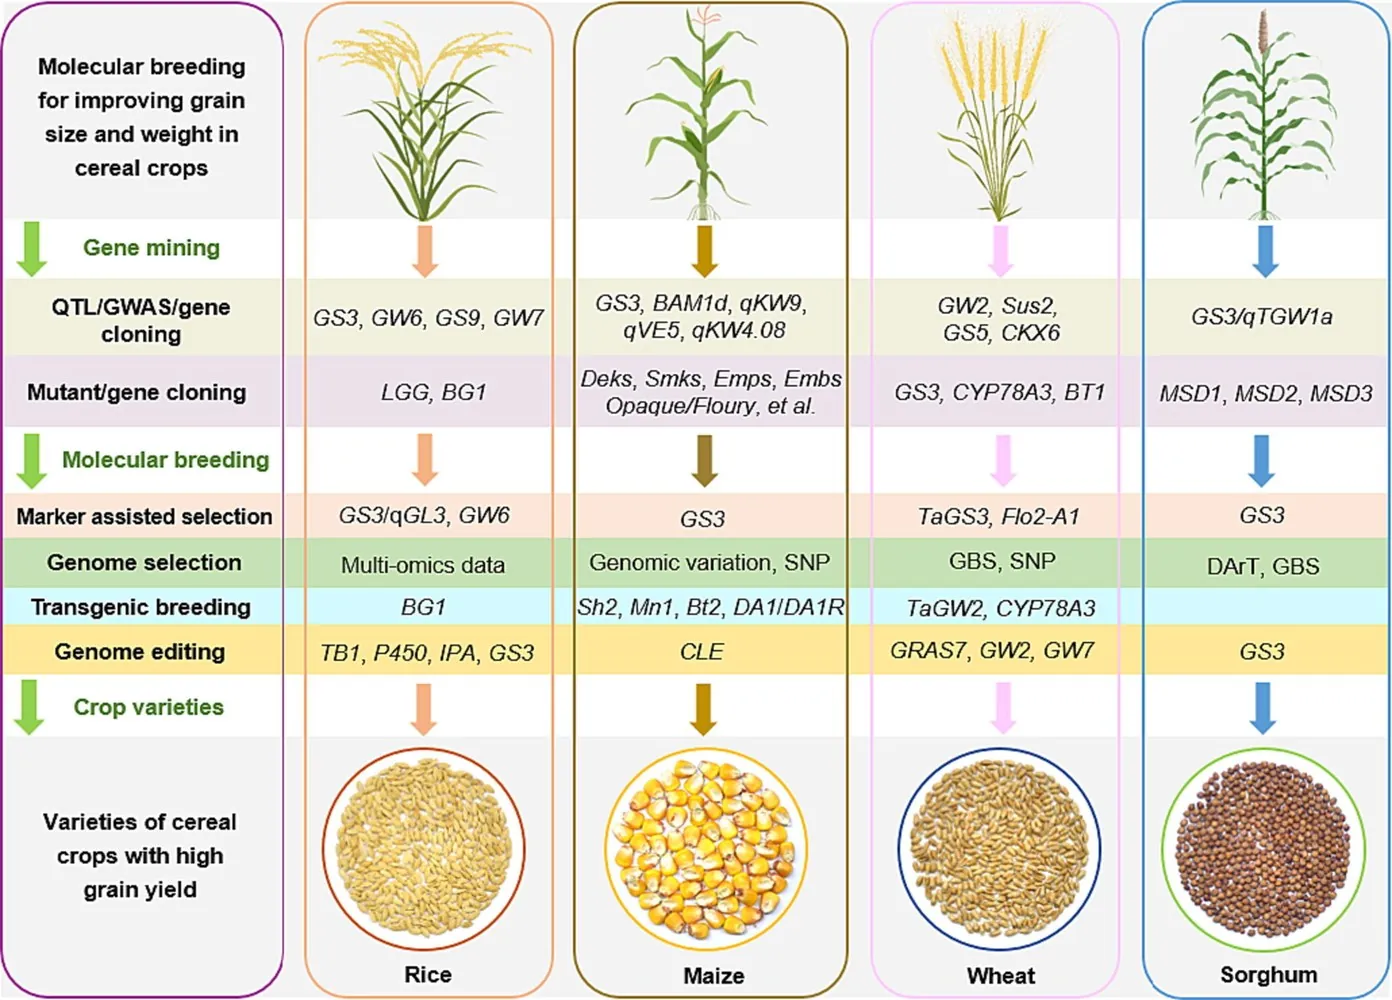
禾谷类作物籽粒性状分子机制与育种应用综述绘图
主要禾谷类作物粒型粒重调控通路与生物育种技术图解 引用来源:J. Adv. Res. 2024, 62, 27–46. doi:10.1016/j.jare.2023.09.016

针对个性化科研需求,我们提供定制化分析、出版级高级图表绘制与论文合作,从数据到成稿全程支持,支持成果发表。

从科学问题拆解、分析方案设计到结果解读与图表打磨,我们提供一对一的高质量定制服务。可视化涵盖 Circos 圈图、共线性图、进化树、热图、网络图、曼哈顿图、森林图与三维基因组图谱等出版级图件。

应用:个性化分析、出版级图表绘制与论文成果发表。
服务优势

为什么选择米源生物的分析服务

以解决问题为导向

围绕真实科学问题设计分析,而非套用标准流程。

擅长复杂基因组与个性化分析

尤其擅长复杂基因组学和个性化定制分析。

既有数据重分析

将闲置或已发表数据重新挖掘,产出新的成果。

端到端服务

从数据质控、分析到育种决策的端到端支持。

服务流程

五步服务,全程陪伴

STEP 01

制定需求

提出具体需求;项目可行性分析;早期时间规划。

STEP 02

合同签订

确认项目细节;合同签署;项目启动。

STEP 03

项目执行

执行项目;阶段反馈;项目总结。

STEP 04

项目交付

交付项目;执行测试;项目文档交付。

STEP 05

项目售后

售后支持;问题解决。

需要技术方案或报价?

告诉我们物种、数据类型与需求,我们将尽快与您沟通。

立即咨询 →